path = system.file("extdata", "case", "simple.ods", package = "floodam.cba")
case = import_case(path)
#> import Case from /usr/local/lib/R/site-library/floodam.cba/extdata/case/simple.ods
#>  ... done
dyke_sa = perform_sa(case, "dyke", n = 1000)
#> Model EAD: 5250
#> Model NPV: -41810
#> Registered S3 method overwritten by 'sensitivity':
#>   method    from
#>   print.src dplyr
#> Evaluating sa_model ...
#>  ... Elapsed time: 0.002028227 secs
#> Sensitivity analysis is performed using sensitivity::sobolmartinez
#> Evaluating sa_sobol ...
#>  ... Elapsed time: 0.4414599 secs
Analyse d’incertitude et de sensibilité : traitements et sorties
2026-11-13
Note
An English version of this article is available: Uncertainty and sensitivity analysis: processing and outputs.
Exécution de l’analyse (perform_sa())
perform_sa() orchestre l’ensemble de la chaîne de calcul d’incertitude et de sensibilité. Elle accepte soit un objet Case (accompagné du nom du project), soit une structure sa_input préalablement construite par prepare_sa().
Les principaux paramètres contrôlant l’estimation sont :
-
n: taille de l’échantillon de base de Monte Carlo (par défautgetOption("floodam.cba")[["n_uncertainty"]]). L’estimation des indices de Sobol évalue simulations (où est le nombre de paramètres incertains) ; -
sobol_method: méthode d’estimation du package sensitivity (par défaut"sobolmartinez"). Passersobol_method = "nominal"ignore les étapes Monte Carlo et Sobol et n’évalue que le scénario nominal ; -
n_boot: nombre de réplications bootstrap pour les intervalles de confiance des indices de Sobol, réglable globalement viagetOption("floodam.cba")[["n_boot"]](par défaut100).
Structure des sorties ("cba_uncertainty")
perform_sa() retourne un objet de classe c("cba_uncertainty", "list") composé de quatre éléments :
names(dyke_sa)
#> [1] "nominal" "u_a" "s_a" "input"-
nominal: valeurs des paramètres et indicateurs ACB (benefit,npv) pour le scénario nominal ; -
u_a:data.frameregroupant les tirages Monte Carlo et les valeurs simulées debenefitetnpv; -
s_a: liste nommée de deux objets Sobol (npvetbenefit) estimés en une seule passe vectorisée du modèle ; -
input: la structuresa_inpututilisée pour la simulation.
Synthèses numériques
dyke_sa[["nominal"]][c("benefit", "npv")]
#> [1] NA NA
summary(dyke_sa[["u_a"]][c("npv", "benefit")])
#>       npv             benefit
#>  Min.   :-236376   Min.   : 1562
#>  1st Qu.:-136497   1st Qu.: 3982
#>  Median : -93615   Median : 5215
#>  Mean   : -81053   Mean   : 5638
#>  3rd Qu.: -36602   3rd Qu.: 6945
#>  Max.   : 233416   Max.   :14970
prop_negative() calcule la proportion de valeurs non positives (par exemple la probabilité que ), globalement ou par classes d’un paramètre donné :
prop_negative(dyke_sa[["u_a"]][["npv"]], dyke_sa[["u_a"]][["npv"]])
#> v
#>    -236376    -184177    -131978     -79778     -27579      24620      76819
#> 1.00000000 1.00000000 1.00000000 1.00000000 1.00000000 0.03030303 0.00000000
#>     129018     181217     233416
#> 0.00000000 0.00000000 0.00000000
Graphiques diagnostiques
La méthode S3 plot() pour les objets "cba_uncertainty" délègue à plot_sa(), offrant un point d’entrée unique vers l’ensemble des visualisations.
Vue combinée (type = "both")
Par défaut, plot() superpose la distribution empirique de l’indicateur et ses indices de sensibilité de Sobol :
plot(dyke_sa, lang = "fr")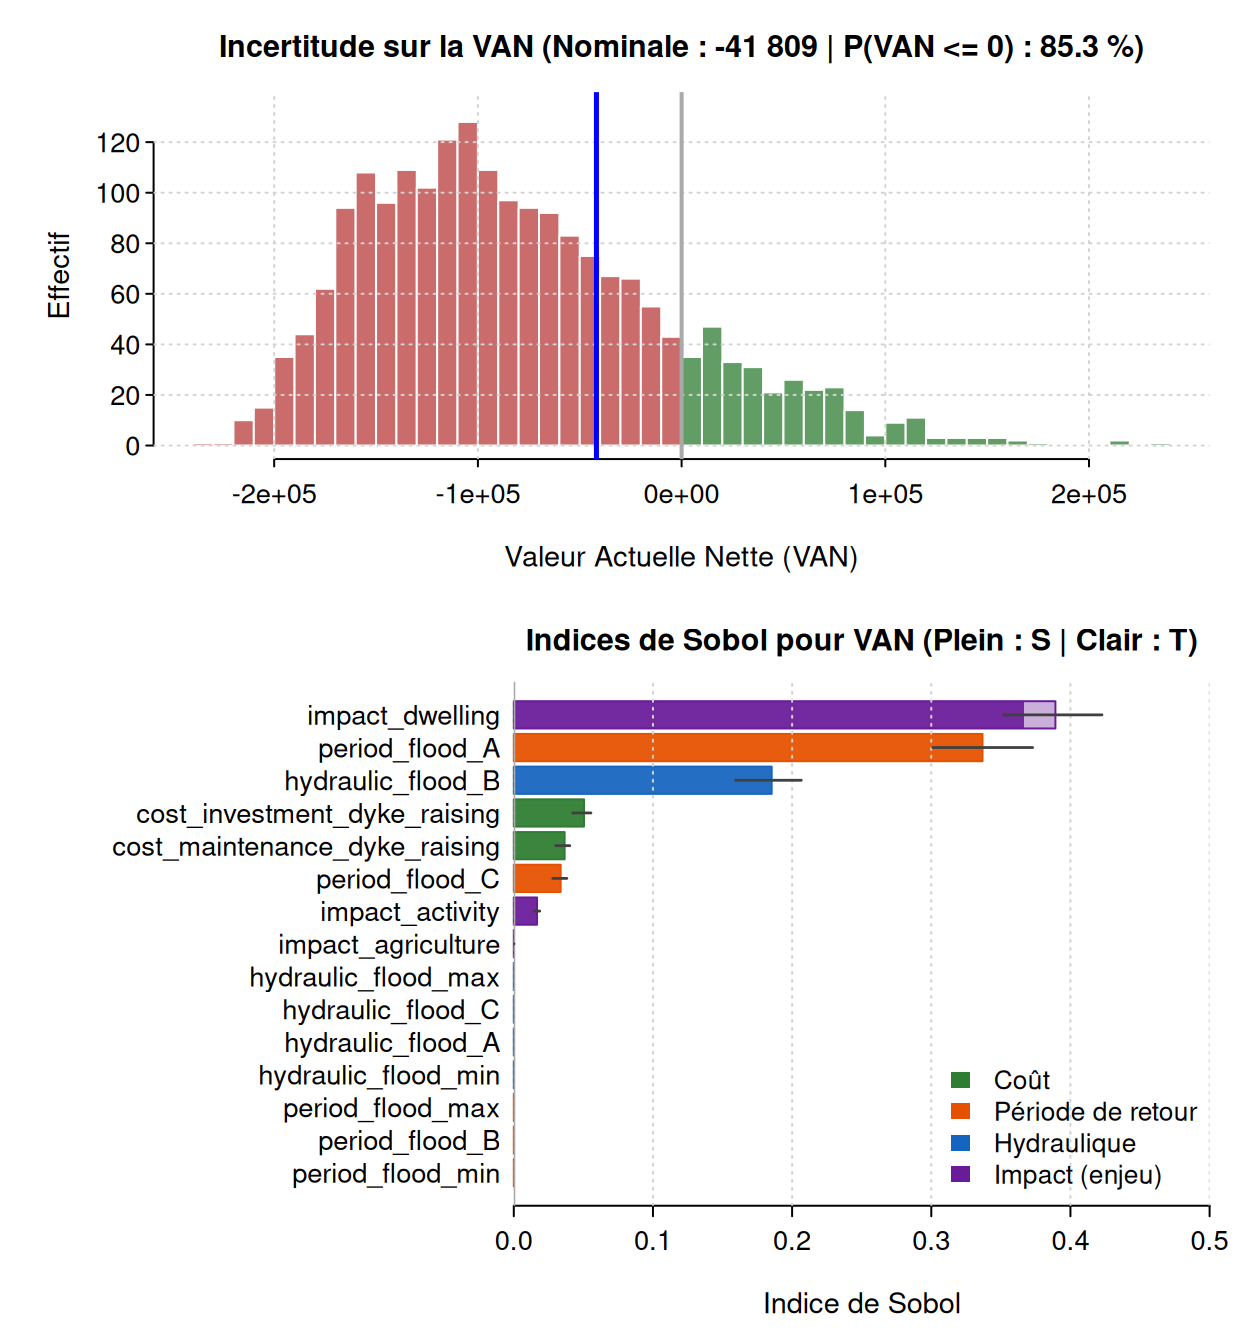
Distribution d’incertitude (type = "uncertainty")
plot_uncertainty() (ou plot(..., type = "uncertainty")) trace l’histogramme et/ou la densité (distrib = c("hist", "density", "both")) de npv ou benefit, avec la référence nominale et le seuil de rentabilité nulle :
plot(dyke_sa, type = "uncertainty", indicator = "benefit", lang = "fr")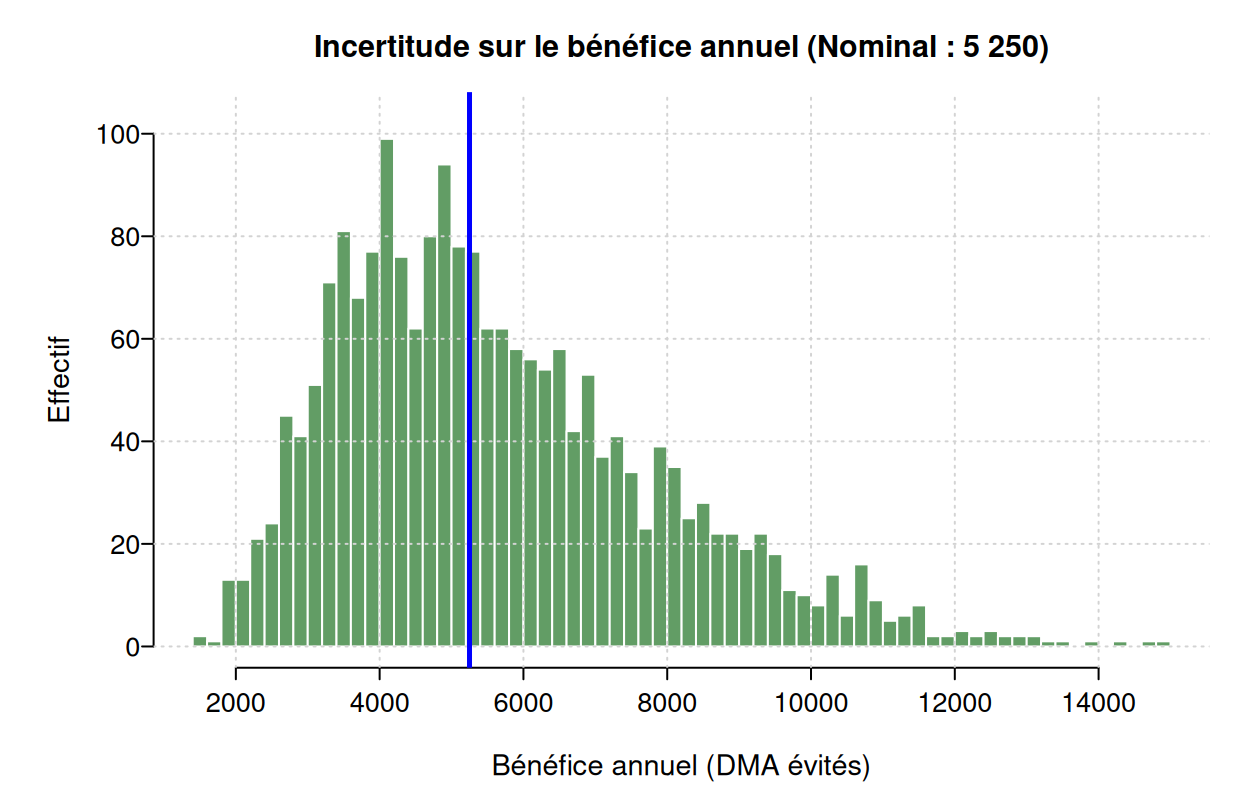
Indices de sensibilité de Sobol (type = "sobol")
plot_sobol() (ou plot(..., type = "sobol")) affiche en barres horizontales les indices du premier ordre () et/ou totaux () (sobol_order = c("both", "total", "first")) avec leurs intervalles de confiance bootstrap, colorés par famille de paramètres (coûts, périodes de retour, efficacité hydraulique, enjeux) :
plot(dyke_sa, type = "sobol", sobol_order = "both", lang = "fr")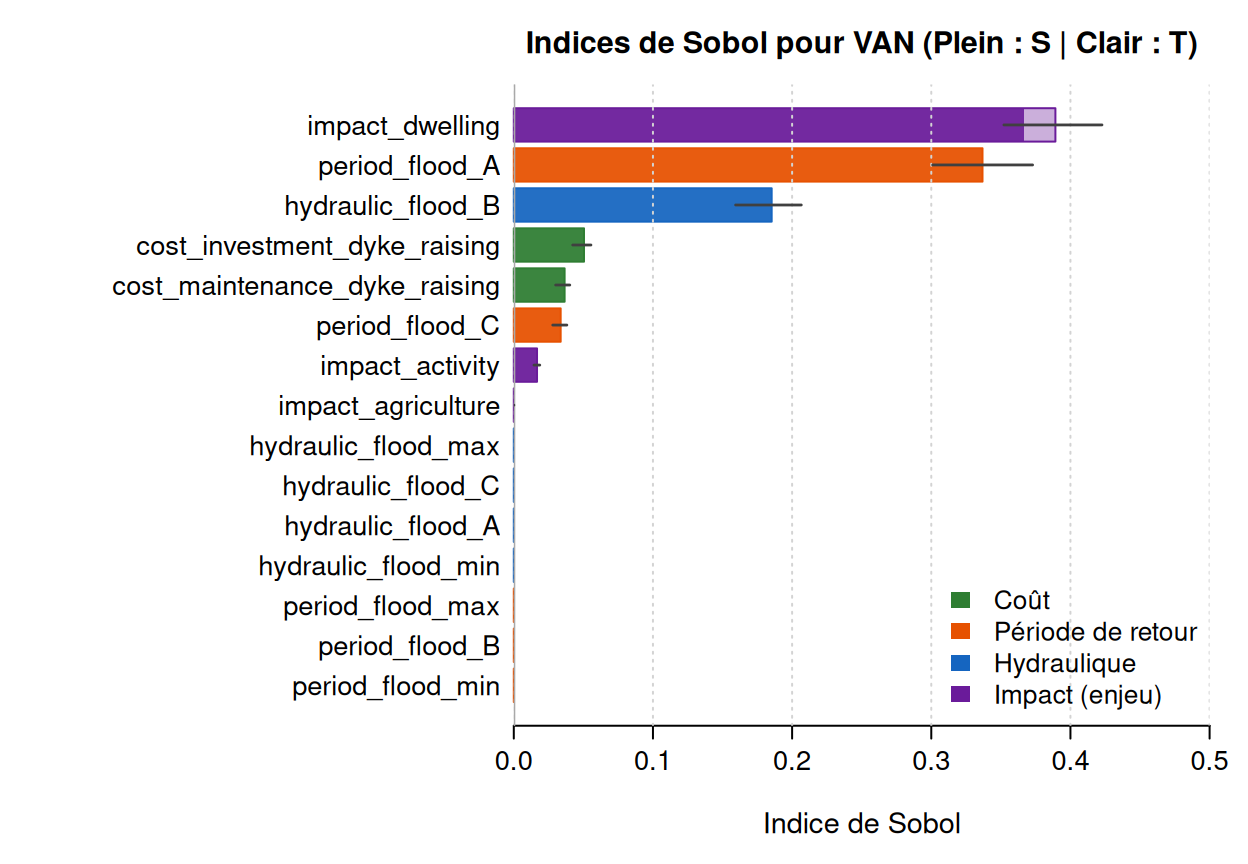
Matrice triplet des interactions (type = "triplet")
plot_sa_triplet() (ou plot(..., type = "triplet")) construit une planche croisant les 3 paramètres les plus influents sur npv (ou benefit), mettant en évidence leurs distributions marginales et les zones où le projet devient non rentable :
plot(dyke_sa, type = "triplet", lang = "fr")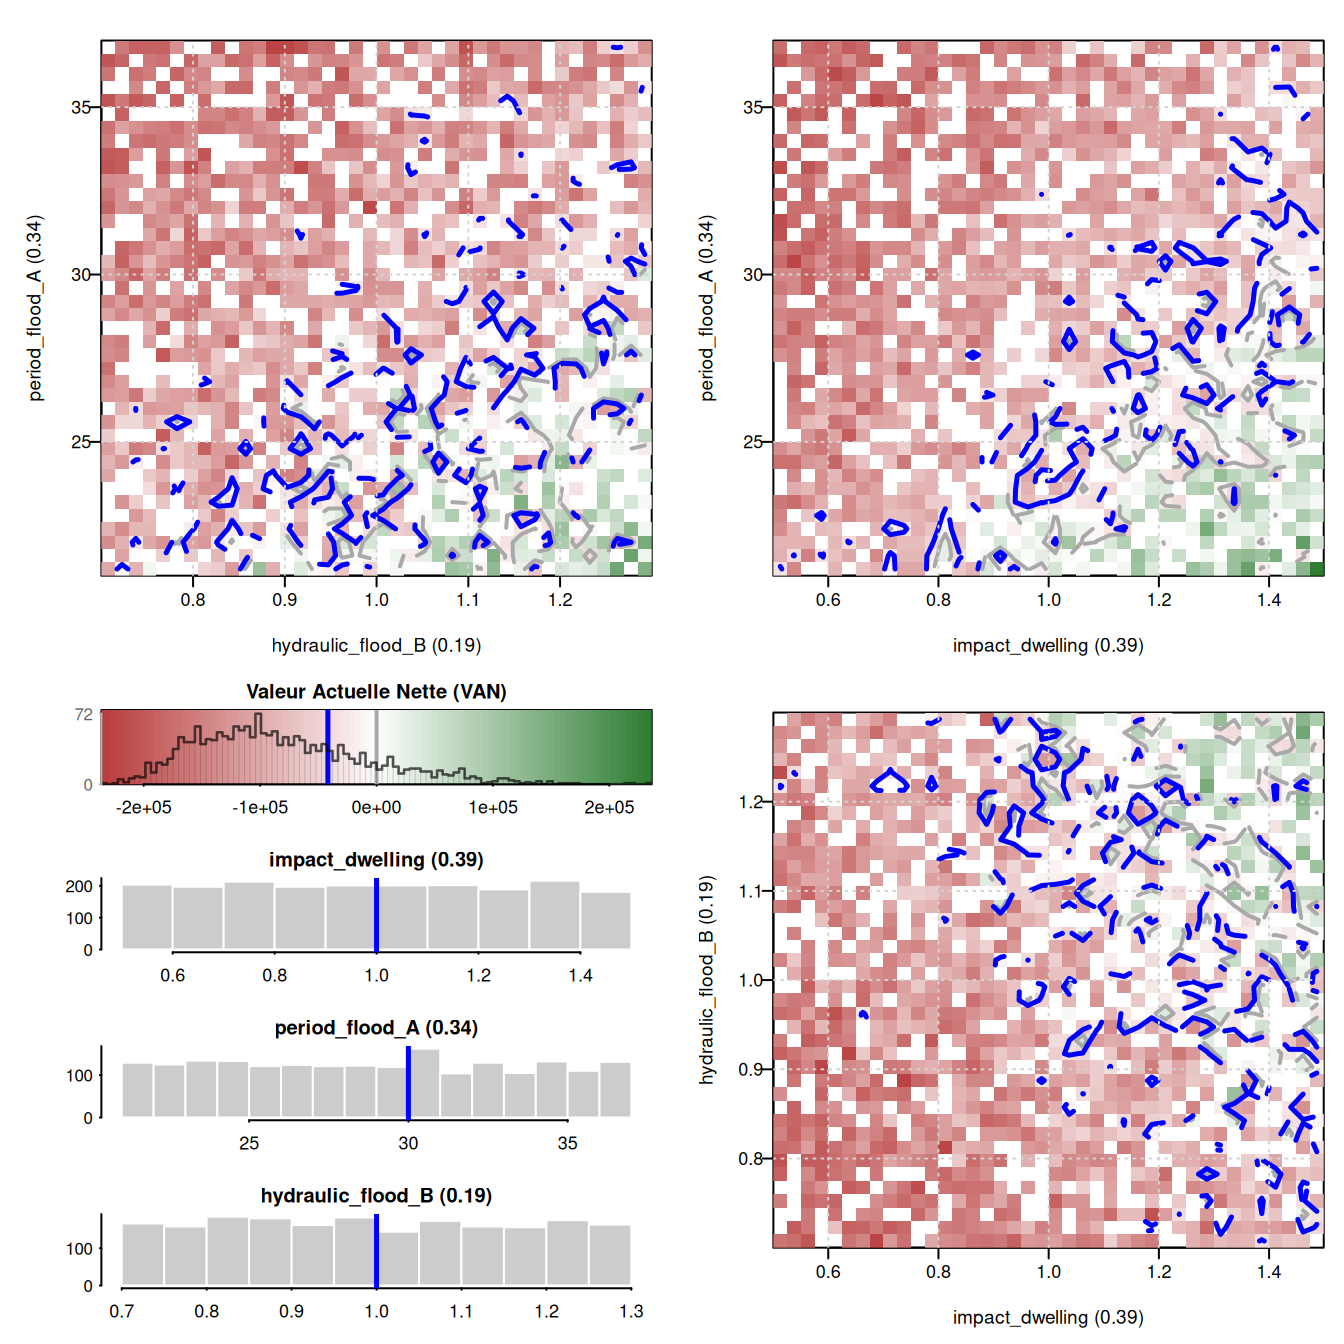
Pour personnaliser la langue des graphiques, l’exportation calibrée A4 ou les options du package (n_uncertainty, n_boot, sobol_method), consultez les articles dédiés Graphiques et gestion des langues et Options du package.